
NLP Tapşırıqlarının Kompüter Vizyonuna Necə Ümumiləşdirilməsinə dair Sadə Bələdçi


Transformator arxitekturasının 2017-ci ildə debüt etdiyi üçün dil modelləşdirmə və maskalı sözlərin proqnozlaşdırılmasından tutmuş tərcümə və sual cavablarına qədər dəyişən, demək olar ki, bütün təbii dil emal tapşırıqları inqilab etdi. Transformatorların bu sahədə də üstün olması 2-3 ildən çox çəkmədi. kompüter görmə vəzifələri. Bu hekayədə transformatorların kompüter görmə dünyasına daxil olmasına imkan verən iki əsas arxitekturanı araşdırırıq.
Mündəricat
· Görmə Transformatoru
∘ Əsas İdeya
∘ Əməliyyat
∘ Hibrid Memarlıq
∘ Strukturun itirilməsi
∘ Nəticələr
∘ Maska ilə Öz-özünə Nəzarətdə Öyrənmə
· Maskalı Autoencoder Vision Transformator
∘ Əsas İdeya
∘ Memarlıq
∘ Yekun qeyd və nümunə
Görmə Transformatoru
Əsas İdeya
Görmə transformatoru sadəcə ümumiləşdirmək üçün nəzərdə tutulub standart transformator emal etmək və şəkil daxiletməsindən öyrənmək üçün arxitektura. Müəlliflərin vurğulamaq üçün kifayət qədər şəffaf olduğu memarlıq haqqında əsas fikir var:
“NLP-də Transformatorun miqyasının artırılması uğurlarından ilhamlanaraq, mümkün olan ən az dəyişikliklə standart Transformatoru birbaşa şəkillərə tətbiq etməyi sınaqdan keçiririk.”
Əməliyyat
Qəbul etmək etibarlıdır”mümkün olan ən az dəyişikliklər” olduqca sözün əsl mənasında, çünki onlar demək olar ki, sıfır dəyişiklik edirlər. Onların faktiki olaraq dəyişdirdikləri giriş strukturudur:
- NLP-də transformator kodlayıcısı a alır bir-isti vektorların ardıcıllığı (və ya ekvivalent token indeksləri) ki daxil olan cümləni/paraqrafı təmsil edir və sonrakı tapşırıqlar üçün istifadə edilə bilən kontekstli yerləşdirmə vektorlarının ardıcıllığını qaytarır (məsələn, təsnifat)
- CV-ni ümumiləşdirmək üçün görmə transformatoru a alır yamaq vektorlarının ardıcıllığı təmsil edən giriş şəkli və sonrakı tapşırıqlar üçün istifadə edilə bilən kontekstli yerləşdirmə vektorlarının ardıcıllığını qaytarır (məsələn, təsnifat)
Xüsusilə, tutaq ki, giriş şəkillərinin ölçüləri (n,n,3) var ki, bunu transformatora giriş kimi ötürsün, görmə transformatorunun etdiyi şey:
- Yuxarıdakı şəkildəki kimi bəzi k üçün onu k² yamaqlarına bölür (məsələn, k=3).
- İndi hər bir yamaq (n/k,n/k,3) olacaq növbəti addım hər bir yamağı vektor halına salmaqdır.
Yamaq vektoru 3*(n/k)*(n/k) ölçülü olacaq. Məsələn, şəkil (900,900,3) olarsa və biz k=3 istifadə etdiksə, yamaq vektoru yastılaşdırılmış yamaqdakı piksel dəyərlərini əks etdirən 300*300*3 ölçüyə malik olacaq. Məqalədə müəlliflər k=16-dan istifadə edirlər. Beləliklə, kağızın adı “Şəkil 16×16 Sözlərə Dəyər: Ölçülü Şəklin Tanınması üçün Transformatorlar” sözü ifadə edən bir isti vektoru qidalandırmaq əvəzinə, təsvirin bir hissəsini təmsil edən bir vektor pikselini təmsil edirlər.
Qalan əməliyyatlar orijinal transformator kodlayıcıda olduğu kimi qalır:
- Bu yamaq vektorları öyrədilə bilən yerləşdirmə təbəqəsindən keçir
- Şəkildə məkan məlumatı hissini saxlamaq üçün hər bir vektora mövqe yerləşdirmələri əlavə edilir
- Çıxış belədir yamaqların_sayı yamaq və ya şəkil səviyyəsində təsnifat üçün istifadə edilə bilən kodlayıcı təsvirləri (hər yamaq üçün bir).
- Daha tez-tez (və kağızda olduğu kimi) CLS işarəsinin önünə bütün təsvir üzrə proqnoz vermək üçün istifadə olunana uyğun təmsil yazılır (BERT-ə bənzər)
Transformator dekoderi haqqında nə demək olar?
Yadda saxlayın ki, bu, transformator kodlayıcısı kimidir; fərq ondadır ki, özünə diqqət əvəzinə maskalı özünə diqqətdən istifadə edir (lakin eyni giriş imzası qalır). Hər halda, siz nadir hallarda yalnız dekoderlə işləyən transformator arxitekturasından istifadə etməyi gözləməlisiniz, çünki növbəti yamağı sadəcə proqnozlaşdırmaq böyük maraq kəsb etməyə bilər.
Hibrid Memarlıq
Müəlliflər həmçinin hibrid arxitektura (CNN-in görmə transformatoruna qidalanma çıxışı) yaratmaq üçün təsvirin özü əvəzinə CNN xüsusiyyət xəritəsi ilə başlamağın mümkün olduğunu qeyd edirlər. Bu halda biz girişi ümumi (n,n,p) xüsusiyyət xəritəsi hesab edirik və yamaq vektorunun ölçüləri (n/k)*(n/k)*p olacaqdır.
Strukturun itirilməsi
Bu arxitekturanın o qədər də yaxşı olmamalı olduğu ağlınızdan keçə bilər, çünki o, olmadıqda təsvirə xətti bir quruluş kimi baxırdı. Müəllif qeyd etməklə bunun qəsdən olduğunu təsvir etməyə çalışır
“İki ölçülü qonşuluq strukturu çox az istifadə olunur… işəsalma zamanı mövqe yerləşdirmələri yamaqların 2D mövqeləri haqqında heç bir məlumat daşımır və yamalar arasındakı bütün məkan əlaqələri sıfırdan öyrənilməlidir”
Transformatorun bunu öyrənə bildiyini görəcəyik, bunun sübutu onun təcrübələrindəki yaxşı performansı və daha da vacibi arxitekturası növbəti məqalədə.
Nəticələr
Nəticələrin əsas nəticəsi budur ki, görmə transformatorları kiçik verilənlər bazaları üçün CNN əsaslı modelləri üstələmir, lakin daha böyük verilənlər dəstləri üçün CNN əsaslı modellərə yaxınlaşır və ya onlardan üstündür və hər iki halda əhəmiyyətli dərəcədə daha az hesablama tələb olunur:
Burada görürük ki, JFT-300M verilənlər bazası (300M təsviri var) üçün verilənlər bazasında əvvəlcədən hazırlanmış ViT modelləri ResNet-ə əsaslanan ilkin göstəriciləri üstələyərək qabaqcadan məşq etmək üçün əhəmiyyətli dərəcədə daha az hesablama resursları götürür. Göründüyü kimi, istifadə etdikləri böyük görmə transformatoru (632M parametrləri ilə ViT-Huge və k=16) ResNet əsaslı model üçün istifadə edilən hesablamanın təxminən 25%-ni istifadə etdi və hələ də ondan üstün oldu. Hesablamanın yalnız
Eyni zamanda, digərləri də ResNet-in cəmi 1,3 milyon təsviri olan ImageNet-1K-da təlim keçdikdə əhəmiyyətli dərəcədə daha yaxşı çıxış etdiyi nəticələri açıqlayır.
Maska ilə Öz-özünə Nəzarətdə Öyrənmə
Müəlliflər BERT-də istifadə olunan maskalı dil modelləşdirmə tapşırığını təqlid edərək (yəni, yamaqları maskalamaq və onları proqnozlaşdırmağa cəhd etməklə) özünə nəzarət üçün maskalı yamaq proqnozu üzərində ilkin araşdırma aparıblar.
“Biz ilkin özünə nəzarət təcrübələri üçün maskalı yamaq proqnozlaşdırma məqsədindən istifadə edirik. Bunun üçün biz yamaqların yerləşdirilməsinin 50%-ni ya onların yerləşdirilməsini öyrənilə bilən ilə əvəz edirik. [mask] yerləşdirmə (80%), təsadüfi başqa yamaq yerləşdirmə (10%) və ya sadəcə olaraq onları olduğu kimi saxlamaq (10%).
Öz-özünə nəzarət edilən ilkin hazırlıqla onların daha kiçik ViT-Base/16 modeli ImageNet-də 79,9% dəqiqliyə nail olur ki, bu da sıfırdan məşq üçün 2% əhəmiyyətli irəliləyişdir. Ancaq hələ də nəzarət edilən hazırlıqdan 4% geri qalır.
Maskalı Autoencoder Vision Transformator
Əsas İdeya
Görmə transformatoru kağızından gördüyümüz kimi, giriş şəkillərində yamaqların maskalanması ilə ilkin məşqdən əldə edilən qazanclar adi NLP-də olduğu qədər əhəmiyyətli deyildi.
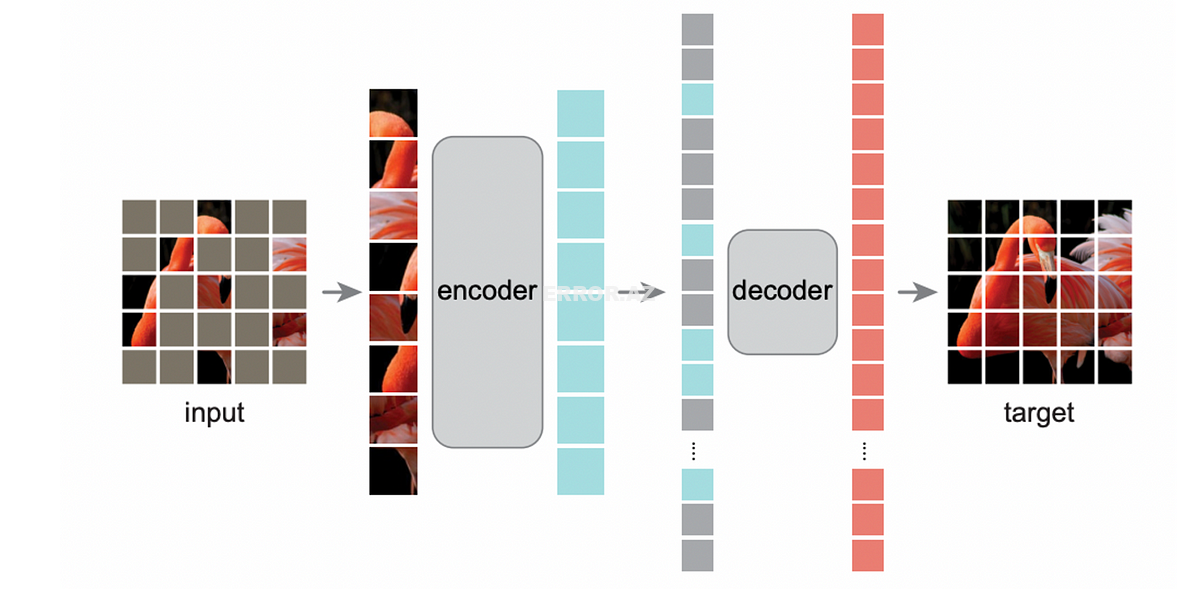
Bu məqalə kodlayıcı və dekoderi əhatə edən görmə transformatoru arxitekturasını təklif edir ki, bu da maskalanma ilə əvvəlcədən öyrədildikdə, əsas görmə transformatoru modeli üzərində əhəmiyyətli təkmilləşdirmələrə səbəb olur (nəzarət altında əsas ölçülü görmə transformatorunun təlimi ilə müqayisədə 6%-ə qədər təkmilləşdirmə).
Bu bəzi nümunələrdir (giriş, çıxış, həqiqi etiketlər). Bu, çatışmayan yamaları doldurarkən girişi yenidən qurmağa çalışdığı mənasında avtomatik kodlayıcıdır.
Memarlıq
Onların kodlayıcı sadəcə daha əvvəl izah etdiyimiz adi görmə transformator kodlayıcısıdır. Təlimdə və nəticədə yalnız “müşahidə olunan” yamaqları götürür.
Bu arada onların dekoder həm də sadəcə adi görmə transformatoru kodlayıcısıdır, lakin bu tələb olunur:
- Çatışmayan yamalar üçün maskalı token vektorları
- Məlum yamaqlar üçün kodlayıcı çıxış vektorları
Beləliklə, bir şəkil üçün [ [ A, B, X], [C, X, X], [X, D, E]]burada X çatışmayan yamağı ifadə edir, dekoder yamaq vektorlarının ardıcıllığını alacaq [Enc(A), Enc(B), Vec(X), Vec(X), Vec(X), Enc(D), Enc(E)]. Enc yamaq vektoru verilmiş kodlayıcı çıxış vektorunu qaytarır və X çatışmayan nişanı təmsil edən vektordur.
The son qat dekoderdə kontekstli yerləşdirmələri (dekoderdəki görmə transformatoru kodlayıcısı tərəfindən istehsal olunur) yamaq ölçüsünə bərabər uzunluq vektoruna uyğunlaşdıran xətti təbəqədir. Zərər funksiyası orijinal yamaq vektoru ilə bu təbəqə ilə proqnozlaşdırılan arasındakı fərqi kvadratlaşdıran orta kvadrat xətadır. Zərər funksiyasında biz yalnız maskalı tokenlərə görə dekoder proqnozlarına baxırıq və indikilərə uyğun gələnlərə (yəni, Dec(A),. Dec(B), Dec(C) və s.) məhəl qoymuruq.
Yekun qeyd və nümunə
Təəccüblü ola bilər ki, müəlliflər şəkillərdəki yamaqların təxminən 75%-ni maskalamağı təklif edirlər; BERT sözlərin yalnız 15%-ni maskalayardı. Onlar belə əsaslandırırlar:
Şəkillər, böyük məkan ehtiyatı olan təbii siqnallardır – məsələn, itkin yamaq hissələri, obyektləri və səhnələri çox az yüksək səviyyədə başa düşməklə qonşu yamaqlardan bərpa edilə bilər. Bu fərqi aradan qaldırmaq və faydalı xüsusiyyətləri öyrənməyi təşviq etmək üçün biz təsadüfi yamaların çox yüksək hissəsini maskalayırıq.
Bunu özünüz sınamaq istəyirsiniz? Bunu yoxlayın demo notebook NielsRogge tərəfindən.
Bütün bunlar bu hekayə üçündür. Biz fundamental transformator modellərinin kompüter görmə dünyasına necə ümumiləşdiyini anlamaq üçün səyahət etdik. Ümid edirəm ki, bunu aydın, dərkedici və vaxtınıza dəyər tapmısınız.
İstinadlar:
[1] Dosovitskiy, A. və b. (2021) Şəkil 16×16 sözə bərabərdir: miqyasda təsvirin tanınması üçün transformatorlar, arXiv.org. Burada mövcuddur: https://arxiv.org/abs/2010.11929 (Daxil olub: 28 iyun 2024).
[2] O, K. və b. (2021) Maskalı avtokodlayıcılar genişləndirilə bilən görmə öyrənənləridir, arXiv.org. Burada mövcuddur: https://arxiv.org/abs/2111.06377 (Daxilolma tarixi: 28 iyun 2024).